Stanford's OpenWAM framework isolates design choices in world-action models
Stanford researchers led by Li Fei-Fei, Jiajun Wu, and Ehsan Adeli released OpenWAM, an open framework for composable world-action models, aiming to systematically isolate which design choices drive performance gains. The release follows Black Forest Labs' open-source FLUX 3 Action, a 7B world-action model that surpassed Cosmos 3 Nano on Nvidia's RoboLab-120 leaderboard with less than half the parameters.
Coverage timeline
机器之心机器之心
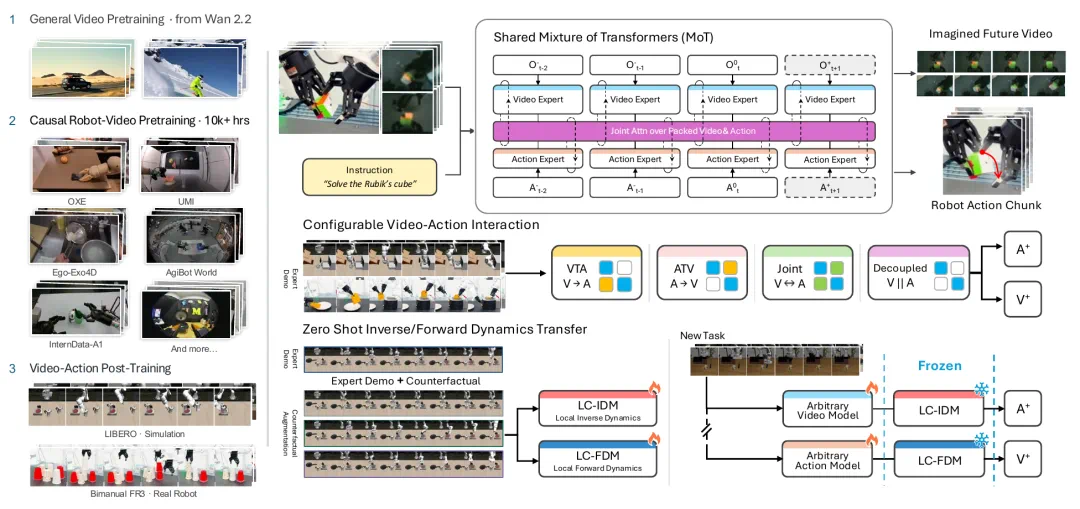
编辑|Panda 9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明 视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座 。 这条路线即所谓 世界动作模型(World-Action Model,WAM) 。自今年 2 月英伟达在 DreamZero 论文中明确提出这一术语以来,相关论文快速涌现。但热闹背后有个尴尬的问题:这些系统几乎都同时换了视频骨干、训练数据、视频与动作的交互方式和推理流程,谁也说不清究竟是哪个设计带来了提升。 本周,斯坦福大学李飞飞、吴佳俊、Ehsan Adeli 等人的团队发布论文,提出开放的世界动作建模框架 OpenWAM ,试图给这个问题一个系统性的回答。 OpenWAM 框架总览:三阶段训练、共享 MoT 架构、四种可配置交互方式,以及可冻结复用的局部动力学模型。 论文标题:OpenWAM: An Open Framework for Composable World-Action Models 论文地址:https://arxiv.org/abs/2610.07922 项目主页:https://openwam.stanford.edu 代码仓库:https://github.com/OpenWAM/OpenWAM 为什么需要一张「统一考卷」 传统的视觉-语言-动作模型(VLA)像一个凭条件反射开车的司机,看到画面、听到指令就直接给出动作。 WAM 则多了一步「脑内预演」: 同时预测接下来几秒画面会怎样,以及为此该怎么动 。视频天然记录了物体如何下落、碰撞和被推动,用海量视频预训练过的模型因此自带物理先验。 问题在于,「预测画面」和「生成动作」可以有很多种耦合方式:先想象再动作,先动作再想象后果,两者同时生成,或者各算各的。各家选择不同、底座和数据也不同,放在一起比较,就像几位厨师同时换了食材、灶具和下锅顺序,很难判断菜好吃究竟归功于哪一步。 第二个问题更隐蔽。机器人训练数据大多是成功示范,只告诉模型「正确的路怎么走」,几乎不包含「手多伸出去两厘米会怎