OpenAI's Jalapeño chip beats Nvidia on inference benchmarks
OpenAI announced first benchmark results for its custom inference ASIC, Jalapeño, developed with Broadcom in about 16 months. Independent testing by SemiAnalysis on the InferenceX benchmark showed the chip outperforming Nvidia, AMD, and Google chips on multiple open-weight models, with 1.5x-1.9x more work per watt and 1.7x-3.6x lower latency than Nvidia GB200/GB300 systems. OpenAI stated it will continue using Nvidia for training.
Coverage timeline
OpenAI Blog
Jalapeño is a custom inference chip from OpenAI that delivers faster, more power-efficient AI inference, with higher throughput and lower latency for modern models.
The Verge AIEmma Roth
OpenAI says its new AI chip, Jalapeño, completes tasks more efficiently and returns responses faster than other AI systems, according to a blog post published on Tuesday. During a briefing with reporters, OpenAI hardware vice president Richard Ho said Jalapeño offers the "best of both worlds" with lower latency and higher throughput, as AI systems typically "have to make a trade-off between the two." First introduced in June , Jalapeño is an Application-Specific Integrated Circuit (ASIC) made in partnership with Broadcom. It's designed for AI inference - the process of running a trained AI model to complete a task or deploy an agent. To mea … Read the full story at The Verge.

Hacker Newsbmulholland
https://www.bloomberg.com/news/articles/2026-08-25/openai-cl... , https://archive.ph/yCTrr
TechCrunch AIRussell Brandom
Tested on SemiAnalysis’ InferenceX benchmark, Jalapeño registered both more tokens per user and more throughput per kilowatt than the currently available state-of-the art.
Techmeme
Emma Roth / The Verge : OpenAI says its Jalapeño chip delivered 1.5x-1.9x more AI work per watt and 1.7x-3.6x lower latency vs. Nvidia chips across GPT-OSS, DeepSeek R1, Kimi K2.5 1T — Jalapeño outperformed Nvidia's superchips on an AI inference benchmark test.

SemiAnalysis : A detailed look at Jalapeño, OpenAI's ASIC developed with Broadcom in 16 months, which beat Nvidia, AMD, and Google chips on multiple top open-weight models — OpenAI's self-designed ASIC compared with Rubin, Jalapeño's TCO, throughput per MW, and spicy deets

量子位量子位
OpenAI「辣椒芯」干翻英伟达!老黄股价不跌反涨 Jay 2026-08-26 09:24:47 来源: 量子位 不和老黄商量 Jay 发自 凹非寺 量子位 | 公众号 QbitAI 倒反天罡了家人们。 刚刚,OpenAI的自研芯片「小辣椒」,跑分 碾压了英伟达最强blackwell 。。。 700W的功耗,最高1.9倍的每瓦吞吐,最低低出3.6倍的推理时延。 不是官方PR,这个数据,来自半导体深度研究机构SemiAnalysis,他们受邀到OpenAI实验室实测。 一般来说,第一代芯片并不具有竞争力。 但SemiAnalysis最终得出的结论是—— OpenAI这颗第一代芯片,在几乎所有场景下都能击败Blackwell。 低延迟、高吞吐、低并发……全部达到SOTA级别。 据悉,Codex在这一过程中扮演了非常重要的角色,部分AI写的内核,甚至比人类写的性能更好。 也是自进化的一种体现吧。 有趣的是,英伟达 股价不仅没跳水,还涨了2.19% 。。。 一方面,英伟达有新产品。 被辣椒狙击同一天,英伟达发布了Jetson Orin Nano 2机器人电脑。 另一方面,可能也和OpenAI的态度有关吧。 小辣椒跑分出来后,公司仍然明确表态不会弃用英伟达,训练仍大量用英伟达,且有双方有融资担保的合作。 倒放天罡!OpenAI芯片碾压黑莓 今年6月,OpenAI官宣与博通(Broadcom)合作这颗专为推理打造的芯片,名为「小辣椒」,设计2024年年中启动,从组队到流片只用了约16个月。 8月25日,OpenAI在Hot Chips 2026大会上公开了这颗自研芯片。 与此同时,更多水下的细节,也在冒出。 SemiAnalysis受邀带着自家InferenceX基准套件,到OpenAI实验室当场实测。 结论是,这颗第一代芯片在多个主流开源模型上,击败了它能测到的所有英伟达、AMD和谷歌芯片。 能效是最大亮点。 小辣椒热设计功耗(TDP)只有700W,Blackwell旗舰加速卡则在1200W到1400W。SemiAnalysis实测,它的每千瓦推理吞吐,达到GB200 NVL72、GB300 NVL72机架系统的 1.5到1.9倍 。 时延同样能打。 端到端推理时延,比英伟达记录的GB200 NVL72、GB300 NVL72最佳成绩 低1.7到3.6倍 ,超低时延场景快2
机器之心机器之心
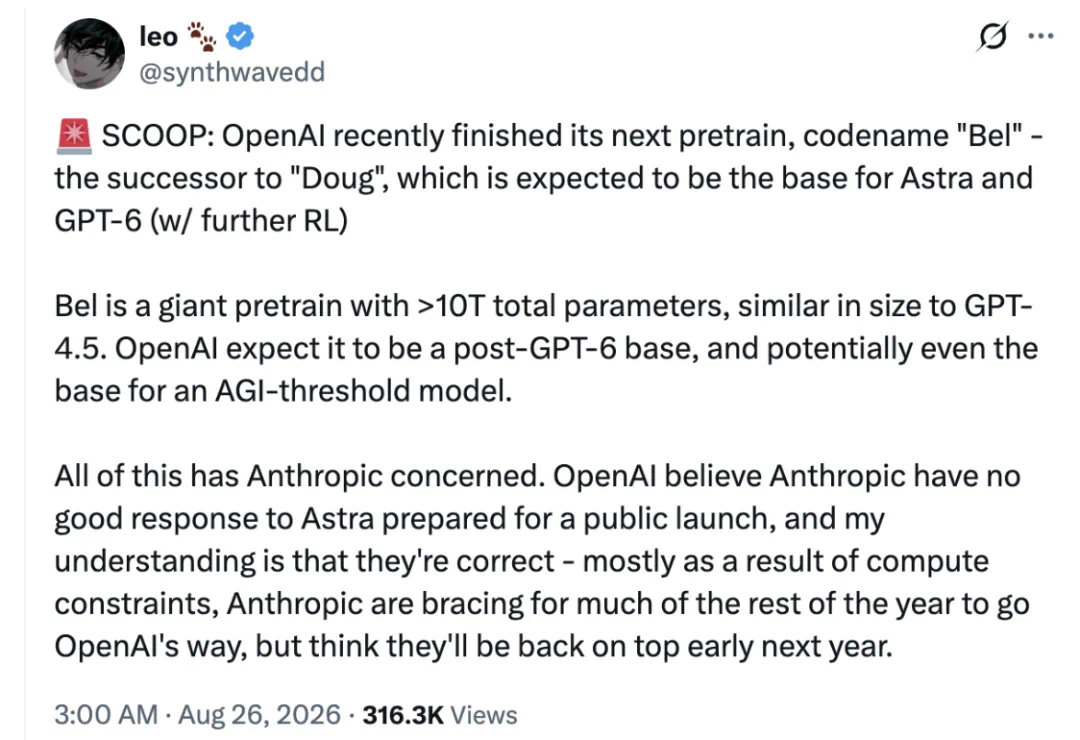
编辑|山辉、Youli 一觉醒来,关于 OpenAI 的消息真是满天飞。 先是 X 用户 Leo@synthwavedd 独家声称: OpenAI 已完成一次新的预训练,代号「Bel」,参数规模据称超过 10 万亿,或是 Doug 的继任者,可能成为 Astra /GPT-6 的基础模型…… 一圈搜索下来发现,并没有准确的消息。但确凿无疑的是,OpenAI 的首款自研推理芯片出成绩了。 就在刚刚, OpenAI 公布了首款自研推理芯片 Jalapeño 的最新测试结果:取得了重大突破,这款芯片专为大语言模型推理设计,通过全新的架构设计,它能够同时提升吞吐量,并降低延迟,在保持高能效的同时,实现两者兼得。并在多个模型测试中超过 NVIDIA GB200、GB300 系统的效率表现 。 随即,OpenAI CEO Sam Altman 也在 X 上表示:「我们制造了一款芯片,它的速度很快。」 需要注意的是,作为 OpenAI 首款自研推理芯片, Jalapeño 并不是用于训练下一代 GPT 模型的芯片,而是针对模型上线后的运行阶段进行优化。 简单来说:训练阶段是让模型学会能力,而推理阶段是让模型快速回答用户请求。Jalapeño 则主要解决的是第二个问题。 OpenAI 表示,传统硬件系统往往需要在两个指标之间做取舍: 更高吞吐量(throughput):单位时间处理更多请求; 更低延迟(latency):让用户更快得到响应。 例如,大规模批处理可以提升整体效率,但可能增加单次请求等待时间;而追求极低延迟,又可能牺牲资源利用率。Jalapeño 的目标,是在一个架构中同时优化两者。 而在具体性能方面,OpenAI 表示,在多个大模型推理测试中, Jalapeño 要优于 NVIDIA GB200 和 GB300 系统 。其中测试模型包括: OpenAI GPT-OSS 120B; DeepSeek R1 670B; Moonshot AI Kimi K2.5 1T 。 尤其引人注意的是 DeepSeek R1 和 Kimi K2.5 的出现,这似乎是在说明:Jalapeño 并不是只针对 OpenAI 自家模型优化,而是能够适配不同的大模型工作负载。 有意思的,Jalape&ntild